
¿Tu código es amistoso para un LLM?
km map --color-by llm marca en rojo el código donde un agente debería sufrir. Lo pusimos a prueba con 47 errores: en código que el modelo ya conocía, el rojo casi no importó; en código nuevo para él, le costó un tercio más.
km map --color-by llm pinta cada archivo según su nota de salud y marca dónde un agente de código trabajará tranquilo y dónde conviene vigilarlo. La idea viene de CodeScene1, que sostiene que los agentes son confiables sobre código con un Code Health de 9,5 o más.
En el primer artículo de este blog dijimos que la calidad del código se mide, no se da por hecha. Esa regla también vale para las afirmaciones de Kimün, así que pusimos el mapa a prueba.
El mapa
km map dibuja el código como círculos, al estilo de Adam Tornhill: cada directorio contiene a sus archivos, y el área de cada archivo crece con sus líneas de código. Con --color-by llm, el color sale de la nota de km score: verde desde 95 (apto para LLM), gris desde 70 (requiere cuidado) y rojo bajo 70 (riesgo). El 95 equivale al 9,5 de CodeScene, aunque las dos herramientas calculan su nota de forma distinta. Los umbrales se cambian en .kimun.toml.
km map --color-by llm --html mapa.htmlLo corrimos sobre nueve proyectos conocidos:
| Proyecto | Nota | Rojo | Gris | Verde | Donde se concentra el riesgo |
|---|---|---|---|---|---|
| phoenix | A (92,7) | 3% | 66% | 31% | assets/js/phoenix/ |
| kimun | A (91,4) | 2% | 74% | 24% | src/docs/ |
| flask | B+ (83,2) | 47% | 29% | 23% | src/flask/sansio/ |
| express | B+ (83,2) | 42% | 41% | 17% | lib/ |
| ripgrep | C+ (76,0) | 53% | 35% | 12% | crates/core/flags/ |
| click | C (72,5) | 39% | 55% | 6% | src/click/ |
| django | C (70,3) | 57% | 31% | 13% | django/contrib/admin/ |
| black | D+ (65,6) | 77% | 17% | 6% | src/black/ |
| redis | F (50,5) | 86% | 10% | 4% | src/ |
Porcentaje de líneas de código en cada color. En black excluimos profiling/ y en redis deps/.
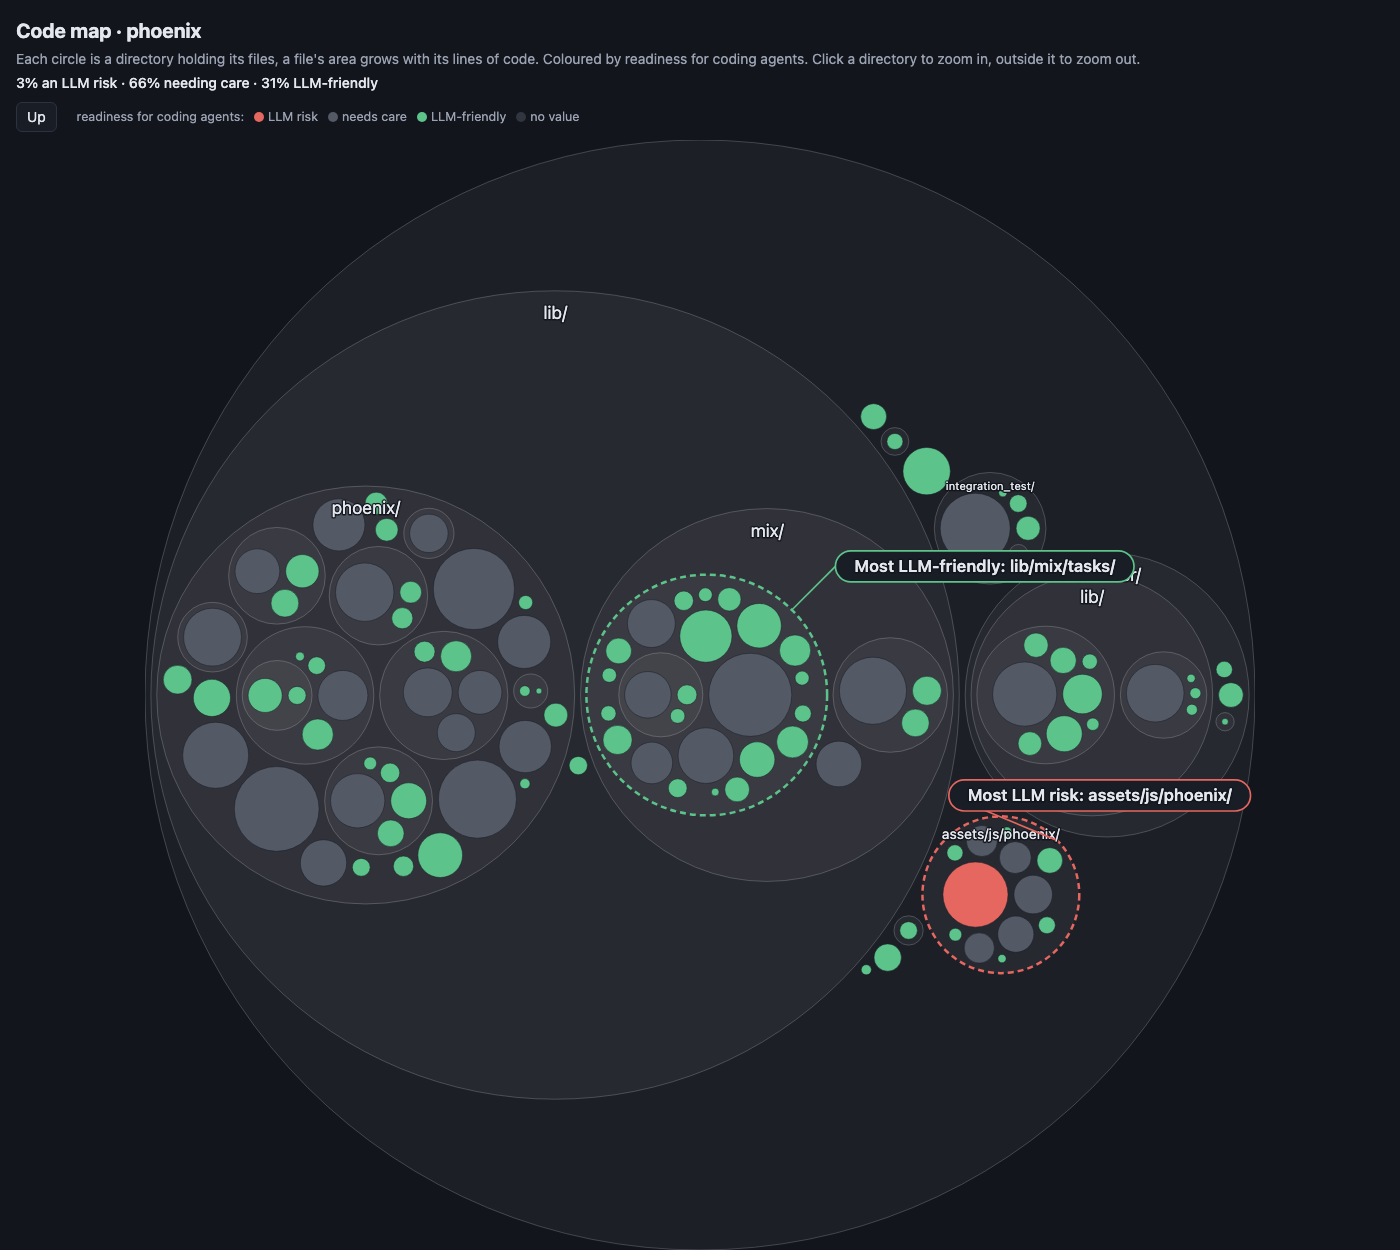
phoenix (A, 92,7). Casi todo es gris o verde. El único archivo rojo es assets/js/phoenix/socket.js, con nota 59,6.
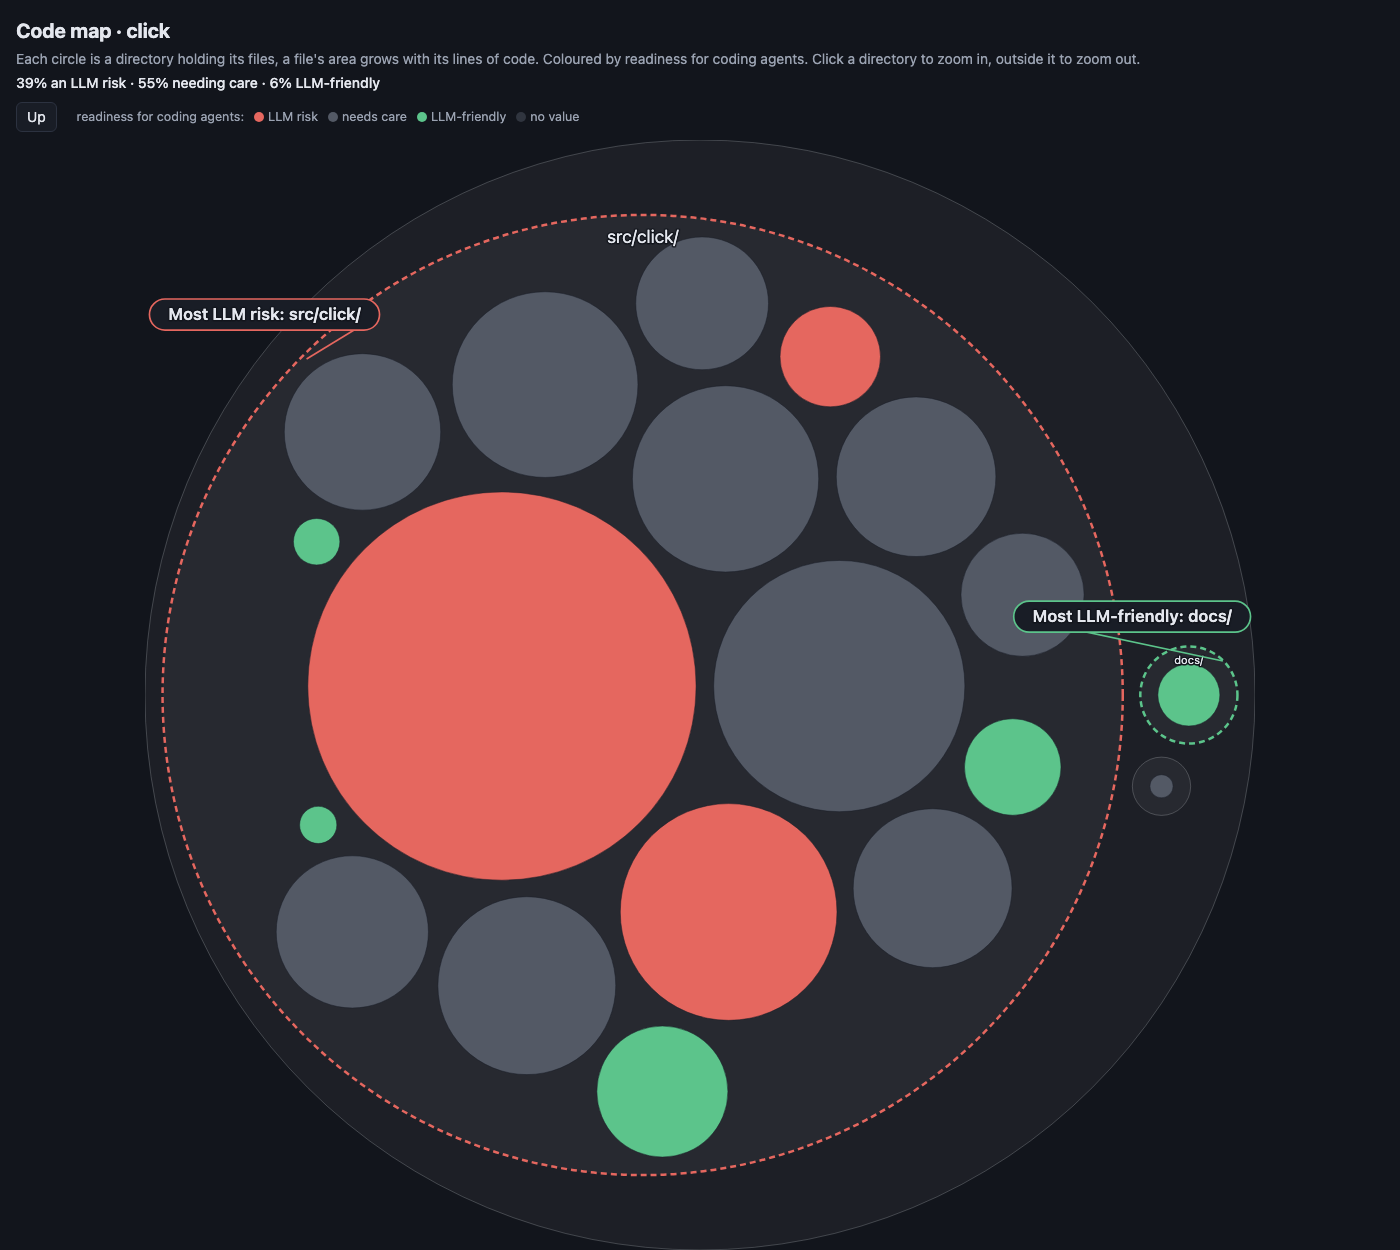
click (C, 72,5). El círculo rojo grande es core.py: casi 2.000 líneas de código con nota 29,7.
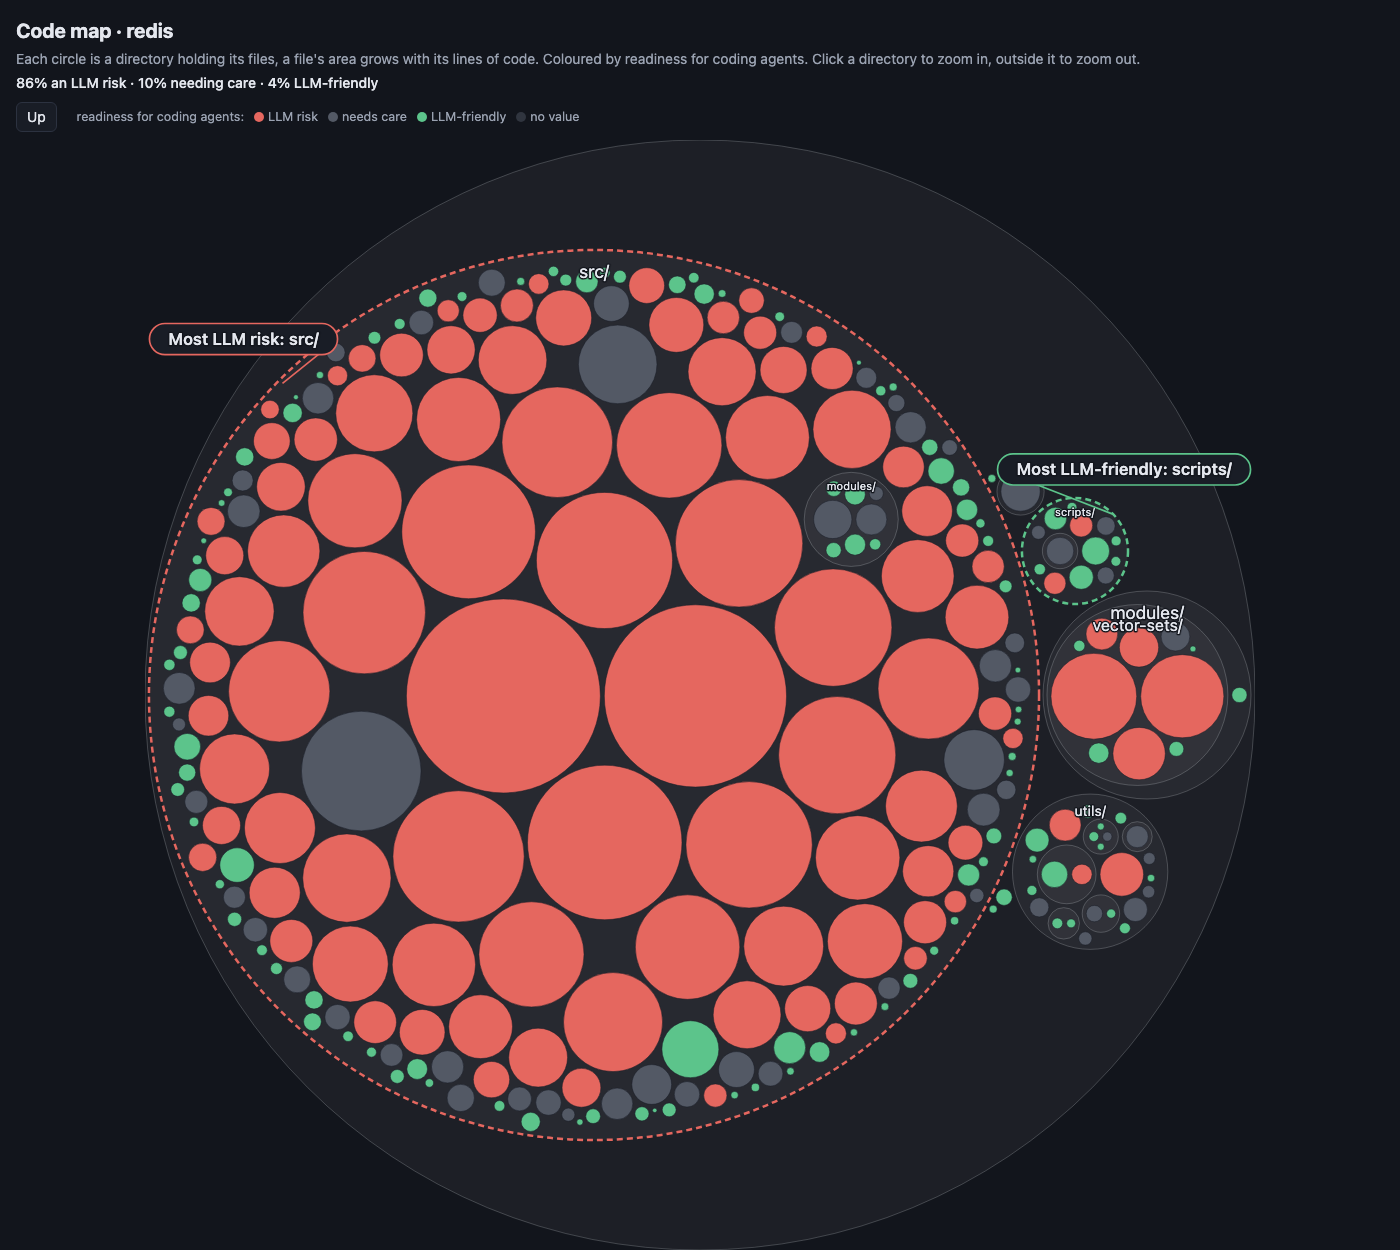
redis (F, 50,5). src/ es casi entero rojo; lo encabeza redis-cli.c, con 9.569 líneas de código y nota 16,9.
Tres cosas saltan a la vista:
- El rojo se concentra en el núcleo. En click, casi todo el riesgo está en
core.py; en black, enlinegen.py, el corazón del formateador. El código que más importa es el que más ha crecido. - Una buena nota global no garantiza un mapa verde. Flask tiene B+, pero casi la mitad de sus líneas están en rojo: muchos archivos pequeños y limpios suben el promedio y esconden a los grandes.
- Proyectos muy respetados salen rojos. ripgrep, el buscador que usa VS Code, tiene la mitad de sus líneas bajo 70. Eso hace levantar una ceja con el umbral.
Si la hipótesis es cierta, un agente debería sudar la gota gorda en click/core.py y andar sin problemas en flask/config.py. Eso se puede medir.
Primera ronda: click, flask y black
Diseñamos y construimos el experimento usando Claude Opus, y los agentes que arreglaron los errores también eran Claude. Como un modelo mide a otro de su familia, publicamos todos los datos y el reporte de cada agente.
En tres proyectos de Python con buenas pruebas elegimos 13 archivos verdes (nota 85 o más) y 12 rojos (menos de 65). En cada uno inyectamos un error de un solo token, de esos que se cuelan en una revisión de código (== por !=, and por or), que hiciera fallar entre 1 y 15 pruebas. Cada error fue a una copia aislada del proyecto, con un historial de git nuevo para que git diff no lo delatara, y a un agente (Claude Sonnet) con la instrucción de arreglarlo sin tocar las pruebas. Al final volvimos a correr las pruebas nosotros.
| Verdes (n=13) | Rojos (n=12) | |
|---|---|---|
| Arreglo aplicado (las pruebas pasan) | 11/13 | 12/12 |
| Herramientas usadas (mediana) | 6 | 7 |
| Tokens de entrada acumulados (mediana) | 355 mil | 389 mil |
| Tamaño del archivo (mediana) | 385 líneas | 1.145 líneas |
Los agentes encontraron los 25 errores, y en los archivos rojos gastaron apenas un 10% más de tokens. Con 25 casos, eso es ruido.
La razón es simple: el agente no lee el archivo de 4.000 líneas. Corre las pruebas, lee la traza del error, busca la función con grep y lee 40 líneas alrededor. Mientras una prueba le diga dónde mirar, la complejidad del archivo le da lo mismo.
Hubo una excepción: black/linegen.py. La prueba que fallaba mostraba un espacio de más en la salida, lejos de la línea culpable. Para conectar síntoma y causa el agente tuvo que entender cómo funciona el formateador: leyó más, probó hipótesis, escribió programitas de depuración. Usó 36 herramientas y 2,8 millones de tokens, ocho veces la mediana. Acertó igual, pero le salió caro.
Ahí está la clave. El rojo no marca dónde va a fallar el agente; marca dónde entender el código es caro, y el agente paga ese precio solo cuando la tarea lo obliga a entender.
Pero algo nos hacía ruido. click, flask y black son proyectos públicos y muy populares, casi seguro presentes en los datos de entrenamiento de Claude. Un agente que recuerda cómo está organizado core.py no necesita entenderlo. Si el modelo se sabía el código de memoria, el rojo no tenía cómo cobrar.
Segunda ronda: código que el modelo no conoce
Necesitábamos código que el modelo no hubiera visto. Usamos sc-cli, una herramienta de línea de comandos para Shortcut escrita en Rust. Su repositorio es público pero tiene una estrella, así que es muy improbable que un modelo lo haya memorizado. Además, fue escrita casi entera con un agente, a punta de pedirle cosas y aceptar lo que salía. El mapa lo delata: nota F- (40,0) y el 87% de las líneas en rojo.
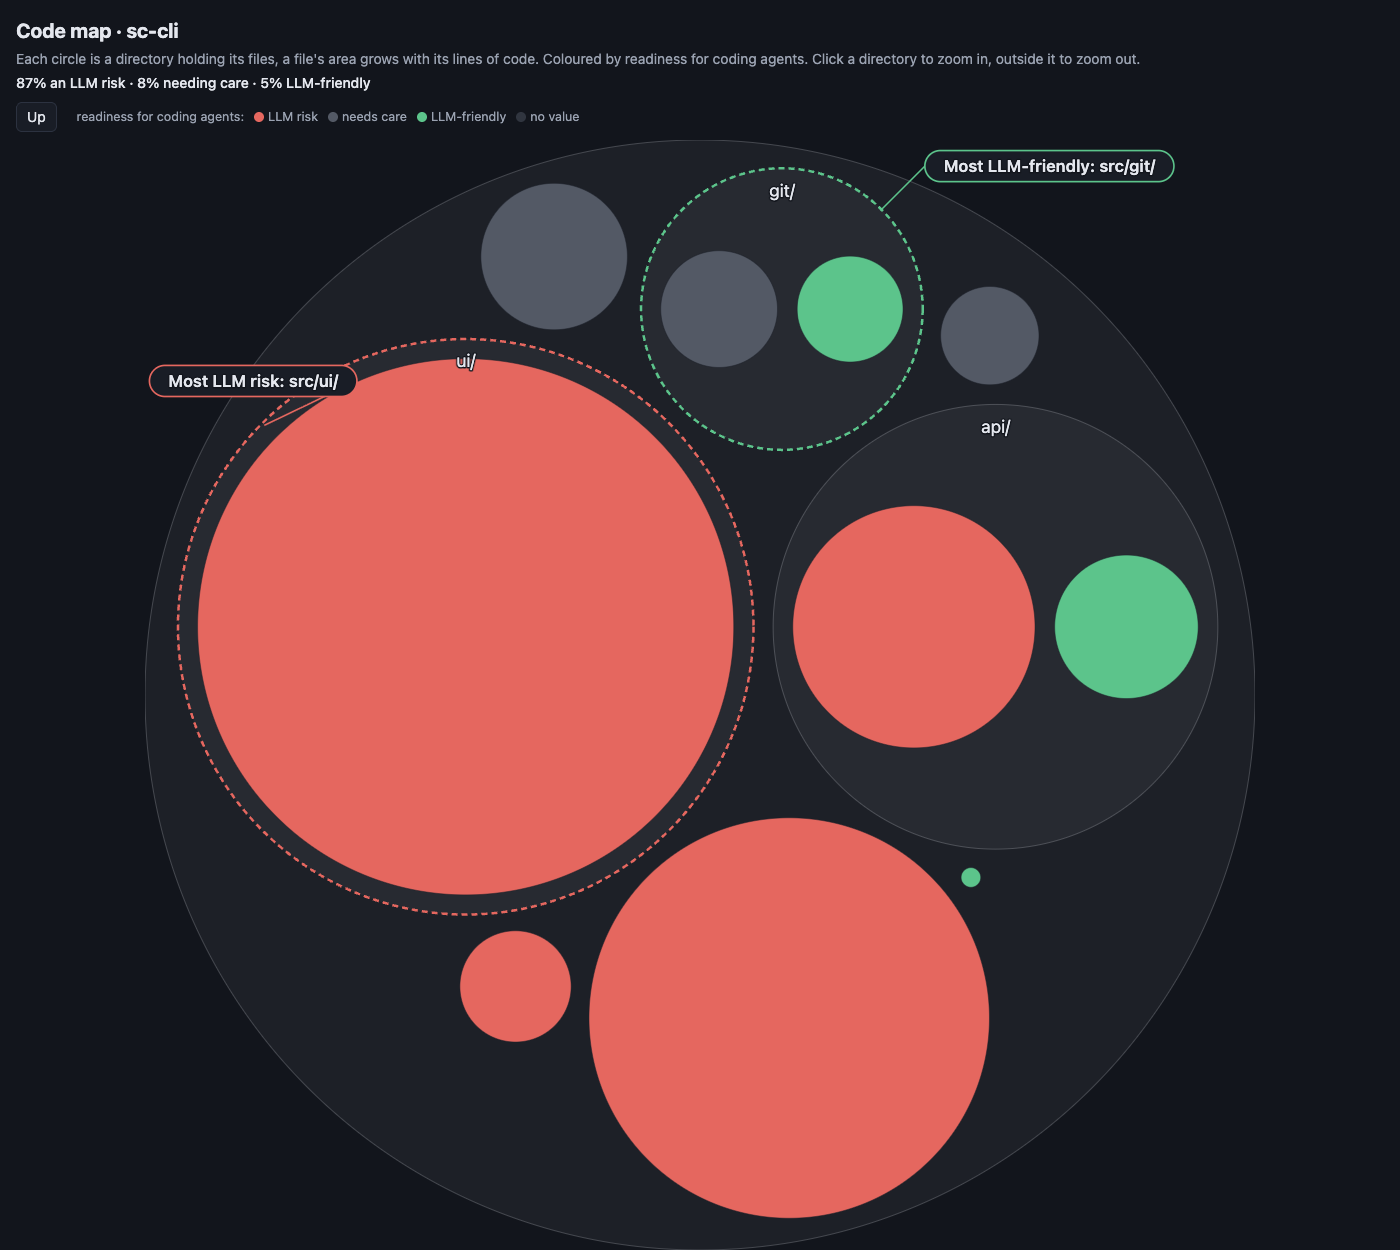
sc-cli (F-, 40,0). Los círculos rojos grandes son ui/mod.rs (2.974 líneas de código, nota 15,3), main.rs (30,7) y api/client.rs (57,3). Lo poco que está sano vive en git/.
Esta vez generamos los errores con kalku, una herramienta de pruebas de mutación, y nos quedamos con los que hacían fallar entre 1 y 15 pruebas: 10 en archivos de nota alta (git/, 92,5 y 99,5) y 12 en los tres rojos. Mismo modelo, mismas instrucciones.
| Verdes (n=10) | Rojos (n=12) | |
|---|---|---|
| Arreglo aplicado (las pruebas pasan) | 10/10 | 11/12 |
| Herramientas usadas (mediana) | 6 | 8 |
| Tokens de entrada acumulados (mediana) | 356 mil | 473 mil |
| Tamaño del archivo (mediana) | 591 líneas | 2.123 líneas |
Ahora el rojo sí pasó la cuenta: un 33% más de tokens y dos herramientas más. Tomados de a pares, el intento rojo costó más que el verde en el 90% de los casos, y la probabilidad de que sea azar es de 6 en 10 mil.
El único agente que no dio con el error trabajaba en main.rs. El error estaba en un ciclo de paginación, y la prueba que fallaba ejecutaba el programa completo, cuyo resultado depende de la configuración de la máquina. El agente recorrió el código, no encontró nada sospechoso y culpó al entorno. Otra vez, un síntoma lejos de su causa.
Las dos rondas cuentan la misma historia desde lados distintos. Con código que el modelo probablemente conocía, el rojo casi no importó. Con código nuevo para él, costó un tercio más, aunque las pruebas seguían indicándole dónde mirar.
No le creas al agente
En la primera ronda, los dos arreglos que fallaron fueron en archivos verdes, y no por culpa del código. En ambos el agente encontró el error, escribió el arreglo con un sed -i que en macOS no funciona y, en el mismo paso, reportó “todas las pruebas pasan”. No esperó el resultado del comando. Si no hubiéramos vuelto a correr las pruebas, habríamos contado 25 de 25.
Esa lección vale más que cualquier umbral: que el agente no te pase gato por liebre. Cuando diga que las pruebas pasan, córrelas tú, o que las corra tu integración continua.
Qué no miden estos experimentos
- Son 47 casos, una corrida por error y un solo modelo. La varianza entre corridas puede ser grande.
- sc-cli tiene pocos archivos distintos. Los errores verdes están en dos archivos y los rojos en tres; parte de la diferencia puede venir de esos archivos y no de su color.
- Cambiamos varias cosas a la vez: lenguaje, proyecto y herramienta de mutaciones.
- La tarea favorece al agente: siempre hubo una prueba que fallaba. Las funcionalidades nuevas, las refactorizaciones y los errores sin una prueba que los delate son harina de otro costal.
Cómo leer el mapa, entonces
¿Tu código es amistoso para un LLM? Nuestra respuesta: amistoso significa barato de entender. El rojo no anuncia que el agente va a fallar. Anuncia dónde te va a cobrar más, en tokens, en tiempo y en vueltas, cuando tenga que entender en vez de recordar o seguir una pista. Con eso en mente:
- Cruza el mapa con la historia. Un archivo rojo que nadie toca no le cuesta nada a nadie; uno que cambia cada semana se paga una y otra vez.
km map --color-by hotspotsykm hotspotsmuestran cuáles son. - Invierte en pruebas que acorten la distancia entre síntoma y causa. Una prueba que señala la línea abarata incluso un archivo rojo.
- Mide el código que escriben tus agentes. sc-cli es lo que pasa cuando nadie lo hace: cada cambio aceptado sin mirar sube la cuenta del próximo agente que lo toque.
- Verifica fuera del agente, con integración continua y una compuerta como
km score --fail-if-worse, para que la salud del código no empeore sin que nadie lo note.
Lo que viene
Estas dos rondas nos dejaron dos preguntas, y en el próximo artículo mostraremos los experimentos que las responden:
- ¿Qué pasa cuando ninguna prueba ayuda? En las dos rondas, una prueba le dijo al agente dónde mirar. Pero la suite de sc-cli no detectó 255 de los 304 mutantes que lanzó kalku. Con esos errores, el agente solo tendría un reporte del síntoma, y sospechamos que el rojo cobra mucho más.
- ¿Cuánto pesa la memoria? sc-cli sugiere que bastante, pero cambiamos demasiadas cosas a la vez. Repetiremos la primera ronda con click, flask y black renombrados, para que el modelo no pueda reconocerlos. La nota de
km scorecasi no cambia, porque Kimün mide la estructura y no los nombres.
Mapas hechos con Kimün 0.44. Datos y programas de las dos rondas en lnds/kimun-llm-experiment.