
Cuando ninguna prueba avisa
Le quitamos al agente la prueba que fallaba y le dimos solo el reporte de un usuario. Arregló los 20 errores casi al mismo costo, y en el código naranja siguió gastando algo más. Antes de llegar ahí, nuestro propio banco de pruebas nos dio gato por liebre.
km map --color-by llm dibuja el código como un mapa y pinta cada archivo según su nota de Kimün, de 0 a 100: de azul los que un modelo debería entender sin esfuerzo, y de naranja los que le van a costar, porque son grandes, anidados y difíciles de seguir. En el artículo anterior pusimos a prueba ese mapa con 47 errores. En código que el modelo conocía, el naranja casi no importó. En sc-cli, un proyecto que casi seguro no estaba en sus datos de entrenamiento, el agente gastó un tercio más de tokens en los archivos naranjas.
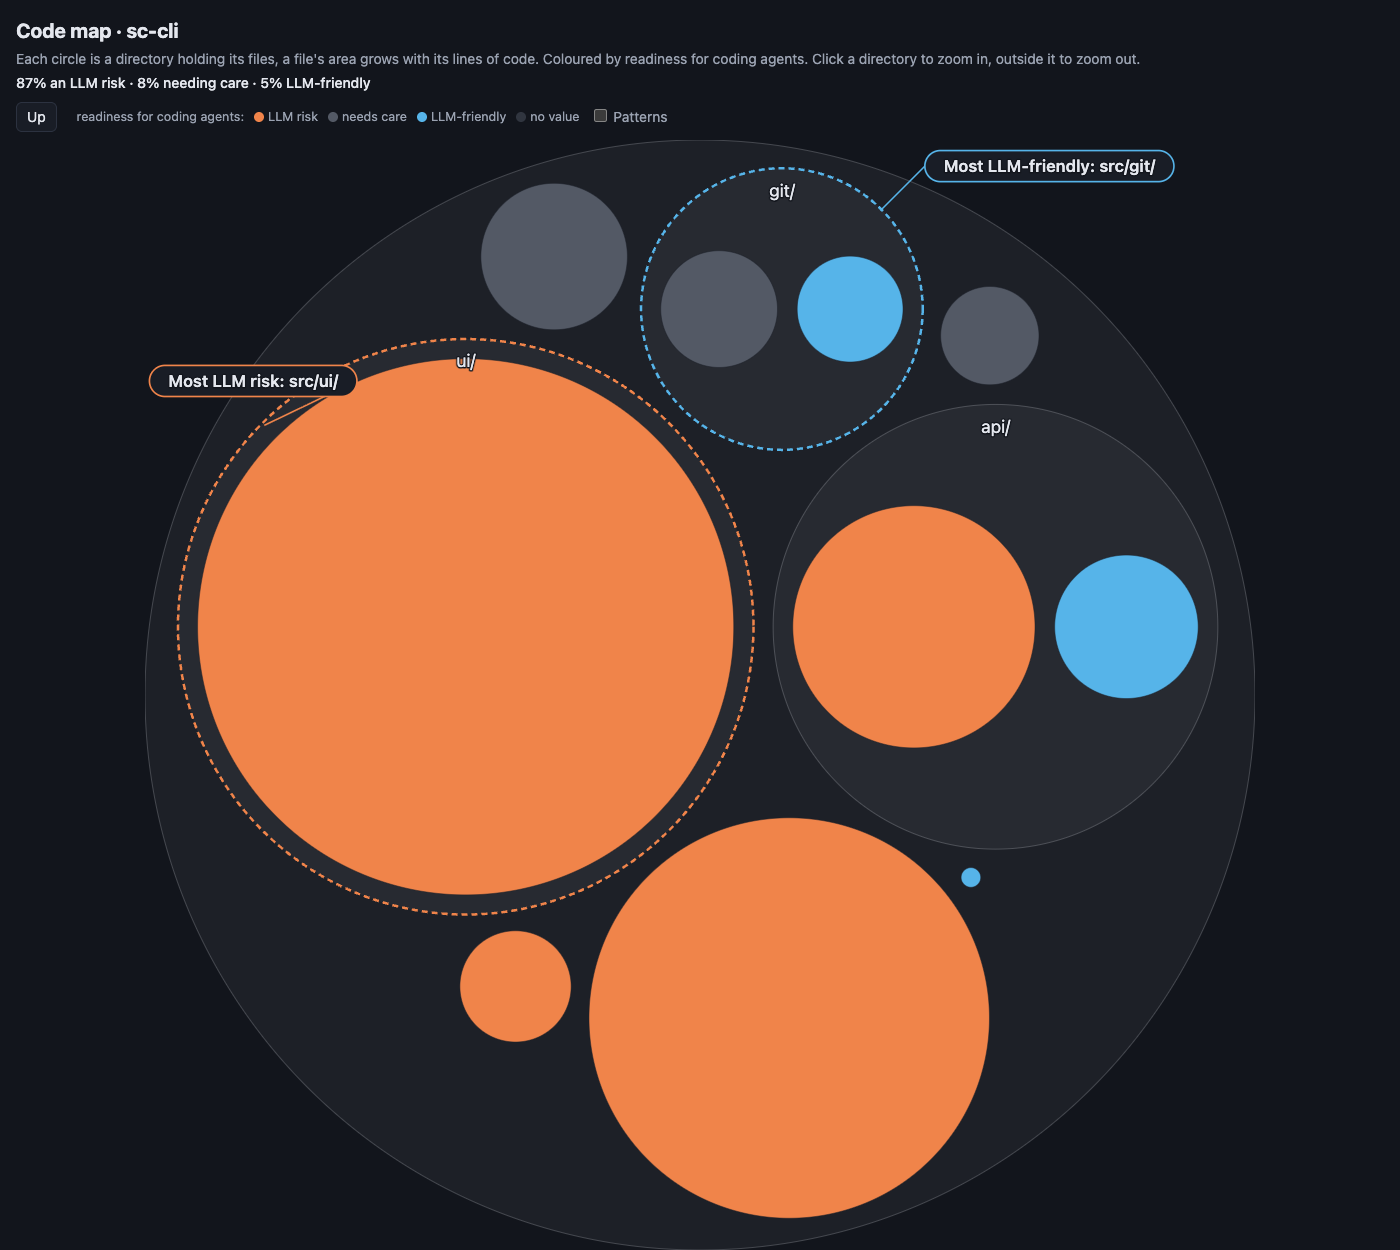
Pero en esas rondas hubo una ayuda que no medimos: siempre había una prueba que fallaba. El agente leía la traza del error, saltaba a la función y leía unas 40 líneas. Con una pista así, el tamaño del archivo casi da lo mismo.
En la vida real no siempre hay pista. Un usuario reporta que algo se comporta raro, la suite está en verde y alguien tiene que encontrar la causa. Pensamos que ahí un archivo difícil de entender iba a costar mucho más. No fue así, y antes de saberlo tuvimos que desconfiar de nuestros propios números.
Los errores que la suite no ve
Para encontrarlos usamos kalku, nuestra herramienta de pruebas de mutación. La idea es vieja y simple: kalku introduce a propósito un error pequeño en el código, un mutante, y corre la suite. Si alguna prueba falla, la suite mató al mutante. Si todas pasan, el mutante sobrevive, y eso revela un comportamiento que ninguna prueba vigila.
Sobre sc-cli, la mayoría sobrevivió. Son cambios de un token (== por !=, un + 1 por + 2, una condición negada) que dejan todas las pruebas en verde. Cada uno es un error que podría estar hoy en producción sin que nadie lo sepa.
| Archivo | Líneas | Nota | Mutantes | Sobrevivieron |
|---|---|---|---|---|
git/mod.rs | 225 | 99,5 | 44 | 41 |
git/operations.rs | 591 | 92,5 | — | 4 |
story_creator.rs | 125 | 87,3 | — | 13 |
api/client.rs | 741 | 57,3 | 60 | 53 |
main.rs | 2.123 | 30,7 | 60 | 57 |
ui/mod.rs | 3.522 | 15,3 | 60 | 43 |
kalku midió operations.rs y story_creator.rs junto con config.rs: 80 mutantes entre los tres, 61 vivos.
Elegimos 20 sobrevivientes, 10 en archivos azules (nota 85 o más) y 10 en naranjas. No todos sirven: algunos mutantes cambian el código, pero no lo que el usuario ve. Para cada uno escribimos una prueba que lo detecta; si no pudimos escribirla, lo descartamos. Esa prueba queda escondida: el agente nunca la ve, y la usamos al final para saber si el arreglo es correcto.
Cómo lo medimos
Mismo modelo (Claude Sonnet) y mismo método que antes: una copia aislada del proyecto por error, con un historial de git nuevo. Lo que cambia es lo que recibe el agente. En vez de “esta prueba falla”, recibe un reporte como el que escribiría un usuario:
sc-cli branch 42siempre me dice “Not a git repository. Please run this command from within a git repository.”, sin importar dónde lo corra. Probé en un clon normal y en un repositorio bare, y git reconoce los dos. Apretargsobre una historia en la interfaz tampoco abre la ventana de ramas.
El reporte describe el síntoma, no la causa: ni el archivo, ni la función, ni la línea. Lo escribimos mirando solo el comportamiento del programa mutado. Las instrucciones le dicen al agente que ninguna prueba reproduce el problema, que puede agregar pruebas propias y que termine cuando la suite pase.
Para cada intento revisamos tres cosas: si la prueba escondida pasa, si pasa el resto de la suite y cuánto costó.
La primera corrida nos dio gato por liebre
Lanzamos los 20 agentes a la vez. Los resultados parecían un titular: sin prueba, todo costaba casi el triple, y el naranja costaba un 47% más, en vez del 33% de antes.
Al leer las sesiones apareció otra historia. Veinte copias compilando Rust al mismo tiempo hacen esperar a cualquiera, y los agentes esperaban mal. Lanzaban cargo test en segundo plano y después lo vigilaban con bucles de sleep, o revisaban la lista de procesos para ver si había terminado. Tres de esos bucles preguntaban pgrep -f "cargo test", y como su propia línea de comandos contenía ese texto, se encontraban a sí mismos: siguieron esperando seis horas después de que todo había terminado.
Cada vuelta de esa espera es un turno más, y cada turno vuelve a enviar todo el contexto. Los más caros de la corrida fueron los que más esperaron.
Repetimos la ronda con 4 agentes a la vez y una línea más en las instrucciones: correr cada comando en primer plano y no mirar otros procesos.
Resultados
| Con prueba que falla | Sin prueba (corrida limpia) | |
|---|---|---|
| Arreglo correcto, azules | 10 de 10 | 10 de 10 |
| Arreglo correcto, naranjas | 11 de 12 | 10 de 10 |
| Herramientas, azul / naranja (mediana) | 6 / 8 | 6 / 7,5 |
| Tokens de entrada, azul / naranja (mediana) | 356 mil / 473 mil | 370 mil / 436 mil |
| Diferencia del naranja | +33% | +18% |
Sin prueba, el agente gastó casi lo mismo que con prueba. El triple de la primera corrida era pura espera. Los 20 arreglos fueron correctos, ninguno rompió otra cosa y en los 20 casos el agente deshizo exactamente la mutación, en el archivo correcto. Cada uno tardó entre uno y tres minutos.
El naranja siguió costando más, pero menos que antes. En 71 de cada 100 pares, el error naranja costó más que el azul. La diferencia de medianas tiene una probabilidad de 5,4% de salir por azar (prueba de permutación), justo en el límite de lo que consideramos convincente. Por sí sola no prueba nada; junto a la ronda con prueba, que apuntó en la misma dirección con mucha más fuerza, muestra una diferencia pequeña y constante.
El reporte es la pista
¿Cómo encuentra un agente un != en 11.500 líneas sin una traza? Leyendo el reporte con cuidado.
En el ejemplo de arriba, el agente buscó el mensaje “Not a git repository” con grep, leyó las primeras 80 líneas de git/mod.rs, vio que la condición estaba al revés y la dio vuelta. Cinco herramientas y 307 mil tokens. Un mensaje de error citado en un reporte hace casi el mismo trabajo que una traza: dice dónde mirar.
Cuando el reporte no trae un mensaje, el camino es más largo. Un usuario contó que al crear una épica la ventana no hacía nada al apretar Enter. No hay texto que buscar, así que el agente buscó “epic” en todo el proyecto, leyó 70 líneas de ui/mod.rs y otras 70 de main.rs para entender quién crea la épica, y recién ahí encontró la condición negada. Nueve herramientas y 510 mil tokens: 66% más que el caso de git/mod.rs.
Eso explica por qué la diferencia es pequeña. El agente nunca lee un archivo de 3.500 líneas entero: busca, lee una ventana y decide. Un archivo naranja le exige una o dos búsquedas más, no una lectura completa. Y como cada turno vuelve a enviar unos 55 mil tokens de contexto base, una búsqueda extra se nota en los tokens aunque casi no cambie lo que el agente leyó.
Lo que hace el agente cuando no hay pista
Teníamos tres preguntas, y las respuestas son claras:
- ¿Escribe una prueba que reproduzca el síntoma antes de tocar el código? Ninguno de los 40 agentes, entre las dos corridas, escribió una sola prueba, aunque las instrucciones lo permitían. Leen, buscan, corrigen y corren la suite. Uno lo dijo con todas sus letras: no agregó prueba porque el código lee directo de la entrada estándar.
- ¿“Arregla” algo que no era el error? Ninguno. Todos cambiaron solo la línea mutada.
- ¿Reporta éxito sin mirar el resultado? En esta ronda, no: todos filtraron la salida de la suite y leyeron el resumen antes de terminar.
Lo primero es lo que más nos importa: un arreglo sin prueba de regresión deja el error listo para volver, y el agente no la escribe si no se la piden.
Qué dice el estudio de CodeScene
En enero, Markus Borg, Adam Tornhill y otros autores publicaron un estudio sobre una pregunta parecida, con otra tarea: le pidieron a varios modelos refactorizar 5.000 programas en Python y midieron cuántas veces rompían las pruebas. Los modelos medianos rompieron entre un 15% y un 30% menos el código sano. Claude Code, en cambio, rompió cerca del 5% en ambos grupos: fue tan conservador que casi solo renombró variables.
Ellos miden si el agente rompe el código; nosotros, cuánto le cuesta arreglarlo. Y dejan pendiente el código muy malo, porque su muestra tenía pocos archivos bajo 7 de Code Health. sc-cli tiene el 87% de sus líneas bajo 70 en la escala de Kimün.
Qué no mide este experimento
- 20 casos, una corrida por error y un solo modelo. La diferencia del naranja está en el límite de lo que estos números pueden afirmar.
- Seguimos en un solo proyecto, con seis archivos distintos.
- Los reportes los escribimos nosotros, y son buenos. Varios citan mensajes de error textuales. Un reporte vago (“a veces no funciona”) puede cambiar el resultado, y es la próxima variable que queremos medir.
- Un mutante es un error artificial. Los errores reales suelen venir de requisitos mal entendidos, no de un
==en lugar de un!=.
Lo que nos llevamos
- Un buen reporte vale casi tanto como una prueba que falla. Si el usuario copia el mensaje de error, el agente llega a la línea con un
grep. Pedir reportes con el texto exacto es la ayuda más barata, sea para una persona o para un modelo. - El naranja cuesta un poco más, siempre. Entre 18% y 33% más de tokens, según la pista. No es un muro, pero se acumula en un equipo que delega mucho.
- El agente no deja pruebas detrás. Si quieres una prueba de regresión, pídela. Los mutantes que sobreviven a kalku muestran justo dónde falta.
- Mide tu banco de pruebas antes que al agente. Nuestra primera corrida medía la contención de la máquina, no el código. Si hubiéramos publicado esos números, el titular habría sido falso.
En el próximo artículo vamos a la otra pregunta: ¿cuánto pesa la memoria? Repetiremos la primera ronda sobre click, flask y black con todos los nombres cambiados, para que el modelo no pueda reconocerlos.
Prueba Kimün
Kimün es de código abierto (licencia MIT) y su código está en github.com/lnds/kimun. Se instala con cargo install kimun o brew install lnds/kimun/kimun, y km map --html mapa.html --color-by llm dibuja el mapa de tu proyecto. Si te sirve, una estrella en el repositorio nos ayuda a que más gente lo encuentre; si algo falla o echas de menos algo, abre un issue.
Los datos, las pruebas escondidas, los reportes y los scripts están en lnds/kimun-llm-experiment.